打开 https://bigmodel.cn/ 的登录页,右上角挂着一行:
新用户免费赠送专享 2000 万 tokens 体验包!
不用绑卡,进去就有。这个数字听起来很实在,但登录页说的是”约数” —— 我把自己控制台里 财务 → 资源包 → 我的资源包 的明细拉出来看了一遍,实际结构比一行宣传语复杂得多,也更有意思。
一、实际发了几个包
我的注册时间是 2026-10-11,控制台里躺着 6 个包:
| 资源包 | 数量 | 状态 | 到期时间 |
|---|---|---|---|
| 【实名认证】500 万 GLM-5.3-Flash 体验包 | 500 万 tokens | 已用完 | 2026-11-11 |
| 【新用户专享】1500 万 GLM-5.3-Flash 资源包 | 1500 万 tokens | 已用完 | 2026-11-11 |
| 【新用户专享】300 万 GLM-5.3-FlashX 资源包 | 300 万 tokens | 已用完 | 2026-11-11 |
| 【新用户专享】20 次图片/视频生成资源包 | 20 次 | 生效中 | 2026-11-11 |
| 【新用户专享】200 万通用模型推理资源包 | 200 万 tokens | 已用完 | 2027-01-11 |
| 【新用户专享】100 次搜索资源包 | 100 次 | 生效中 | 2027-01-11 |
加起来是 2500 万 tokens + 120 次按次计费的调用。
登录页说的”2000 万”,是前两个包的和(1500 + 500)。另外 500 万是拆开给的,而且生效范围不同 —— 这是接下来最关键的细节。
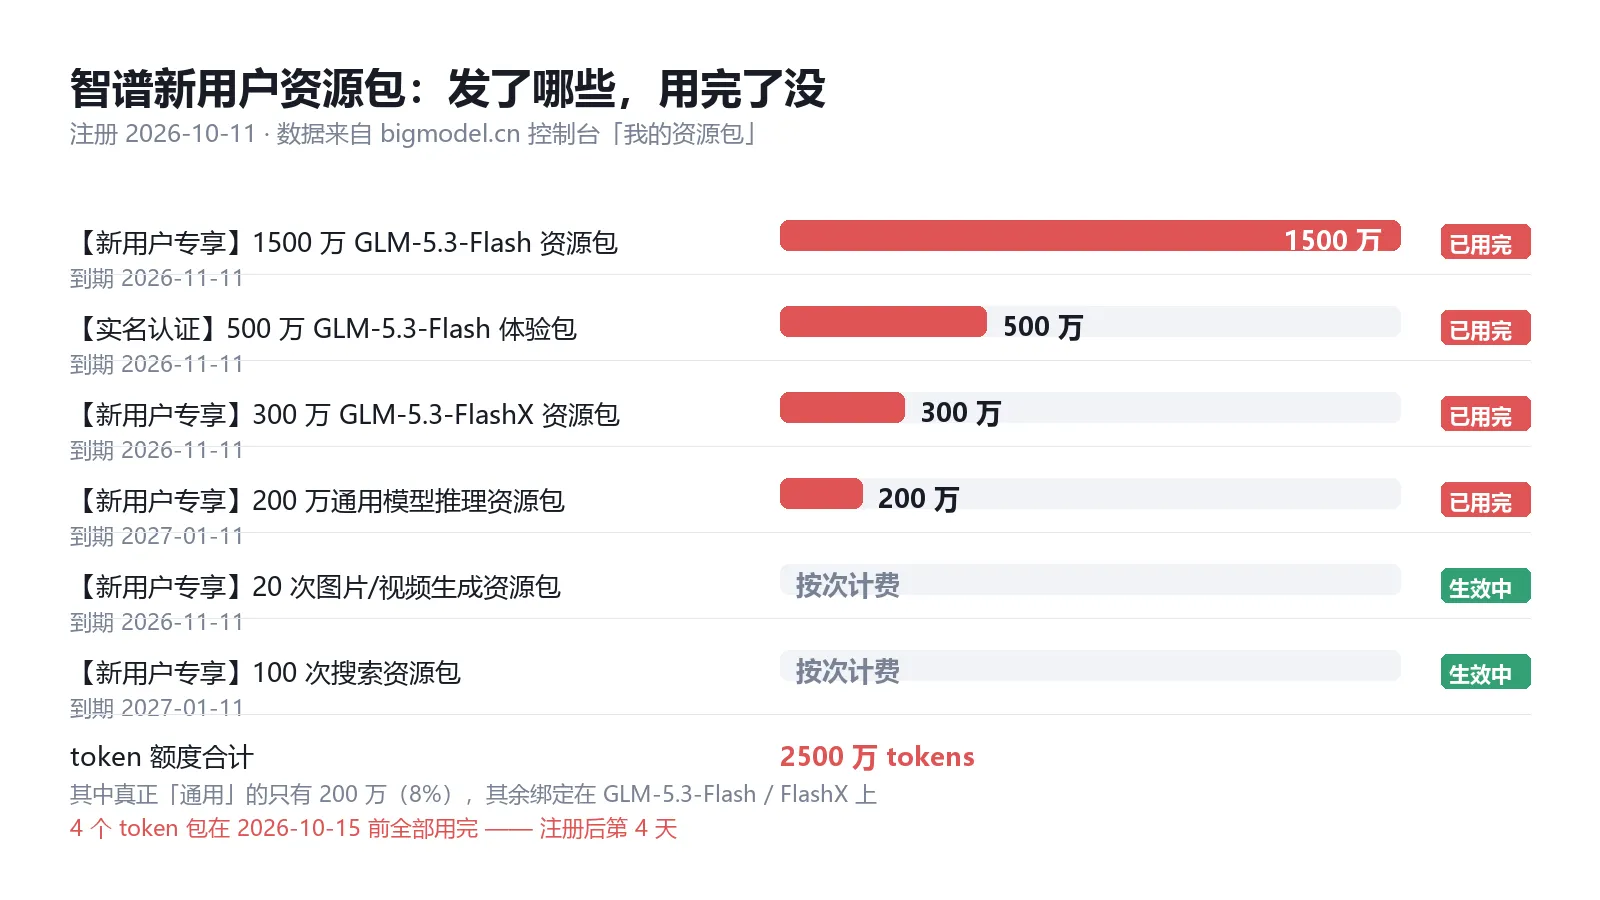
上图是根据控制台数据整理的数据图,不是界面截图。想看原界面的话,登录 bigmodel.cn 走「财务 → 资源包 → 我的资源包」。
二、这 6 个包不是”通用货币”
第一眼看到 2500 万,很容易以为”随便怎么用都行”。不是。「适用场景」那一列才是真正的约束:
1500 万 + 500 万 → 只适用于 glm-5.3-flash 的推理 300 万 → 只适用于 glm-5.3-flashx 的推理 200 万 → 适用于所有按 tokens 计费的基础模型 ← 只有这个是万能的 20 次 → 只适用于图片 / 视频生成 100 次 → 只适用于 search-std / search-pro / search-pro-quark / search-pro-sogou也就是说:
真正”通用”的额度只有 200 万 tokens,占总额度的 8%。剩下 92% 都被绑死在具体模型上。
这直接改变了一套使用策略。你如果拿 GLM-5.3-Flash 之外的模型去跑 agent,能烧的其实只有那 200 万。
NOTE包是按模型粒度拆分发放的,这在国产大模型平台的体验包设计中很常见 —— 既是资源隔离,也是引导你去试它主推的那个型号。理解这一点,才不会在”我明明有 2500 万额度”的时候发现调用报余额不足。
三、4 天烧完
真正让我意外的不是额度大小,是速度。
注册时间 2026-10-11,我今天(10-15)再看,四个 token 包全部「已用完」。
也就是说:2500 万 tokens,4 天。 平均一天六百万。
而且我并不是高强度使用者 —— 主要是拿它在 opencode / 各种 agent 里跑日常的代码任务和文档处理。所以这里有个很反直觉的结论:
WARNING“2000 万 tokens”听起来像能用几个月的数字,实际上是几天的量级。
原因在 agent 场景的 token 结构,而不是你的问题难度:
一个”就改一行”的任务,模型可能读 8 次文件、调 15 次工具,每次工具结果都回灌进上下文。你看到的是行数,它烧的是上下文。
按这个量级反推:
纯聊天能撑很久;带工具调用的 agent,几天就见底。差异是几百倍。
顺便给一个换算是很有用的:控制台的”购买资源包”页里,1000 万 tokens 的新客专享包标价 29.9 元(3 个月有效)。也就是说这 2500 万额度,按购买价折算大概值 70 多元。
70 块钱,4 天。这个数字比任何宣传语都能说明白 agent 到底有多吃 token。
四、怎么用才不亏
基于上面这几点,我总结出四条:
1. 先看「适用场景」,别只看总额
知道通用额度只有 200 万之后,我的做法是:把模型档位分两层。
日常对话 / 简单任务 → 免费模型(不消耗额度)写代码 / 长上下文 / 复杂推理 → token 包(优先用绑定的 GLM-5.3-Flash) → 通用额度当"预算外资金",留给别的模型2. 别拿它测 prompt
新手最容易犯的错是拿 2500 万去调”这个 prompt 写得好不好”。测 prompt 用免费模型,不要用包。 包是一次性资源,用完就没了。
3. 长上下文别拆碎
同一份文档”问三次”和”一次问清再追问”,后者便宜得多 —— 因为前缀被缓存了。碎片化的提问会让缓存命中率崩掉。
4. 盯住到期日
这是最亏的死法:包还在,过期了,一分没花。这批包的有效期分两档:GLM 模型包 1 个月(到 11-11),通用包 3 个月(到 2027-01-11)。领到之后先看一眼日期,然后安排用掉。
TIP注册入口就一个:https://bigmodel.cn/。进去后在控制台创建 API Key,第一次就把 key 存进密码管理器 —— 平台明确说了”API Key 仅在创建时完整展示一次,后续无法查看或恢复”。
顺带一句:平台的资源包页面现在支持按「模型 / 功能 / 工具插件」分类筛选,还有”仅展示可用资源包”的开关。查余额之前记得关掉过滤,不然会以为还有额度。
五、一个额外发现:他们卖的是”尝鲜包”
翻资源包商店的时候,我注意到一个挺有意思的产品设计:绝大部分 SKU 是”尝鲜包”,价格在 2.9 元 ~ 19.9 元之间。
GLM-5.3-Flash 尝鲜包 9.9 元GLM-5.3 尝鲜包 39.9 元GLM-OCR 3 折尝鲜包 2.9 元GLM-Image 3 折尝鲜包 5.9 元GLM-4.6V 3 折尝鲜包 5.9 元GLM-4.5-Air 3 折尝鲜包 19.9 元这不是随便定的价。2.9 元这个价位,意图是让你”无脑点一下”,而不是让你算性价比。平台赌的是你用完尝鲜包之后直接订阅/充值,而不是回头比价。
从用户角度,这反而是好事:
如果你想试某个特定模型(OCR、图像生成、视觉推理),先买它对应的尝鲜包,比直接充值划算得多。 因为尝鲜包是折扣价,而且范围清晰、不需要自己在账单里对账。
这跟前面那个”资源包按模型粒度拆分”是同一个思路的两面:把额度切成小份、绑定到具体能力、用低价降低尝试门槛。
小结
- 登录页写”送 2000 万 tokens”,实际是 2500 万 tokens + 120 次按次调用,分 6 个包
- 只有 200 万(8%)是通用额度,其余都被绑死在 GLM-5.3-Flash / FlashX 上 ——「适用场景」列比总额重要
- 注册 4 天全部用完。agent 场景的 token 消耗是纯聊天的几百倍,别拿聊天量级去估
- 按购买价折算,这 2500 万大概值 70 多元,四天烧完 —— 这就是 agent 的真实成本
- 有效期分两档(1 个月 / 3 个月),过期未用是最亏的
- 想试特定模型,先买对应的”尝鲜包”,比直接充值划算
薅来的东西要有个用完的计划,不然它就是个躺在后台慢慢归零的数字。这次我倒是用完了 —— 只是没想到这么快。